Uno de los mayores desafíos en el tratamiento de las enfermedades raras es justamente identificarlas. Su diagnóstico suele tardar años y para muchas familias comienza como un camino lleno de dudas, visitas médicas, derivaciones y pruebas que se acumulan mientras la incertidumbre crece. Ahora, la UNED acaba de dar un salto cualitativo, con el desarrollo de una herramienta basada en inteligencia artificial, que permite identificar enfermedades raras a partir de informes clínicos reales de atención primaria pediátrica.

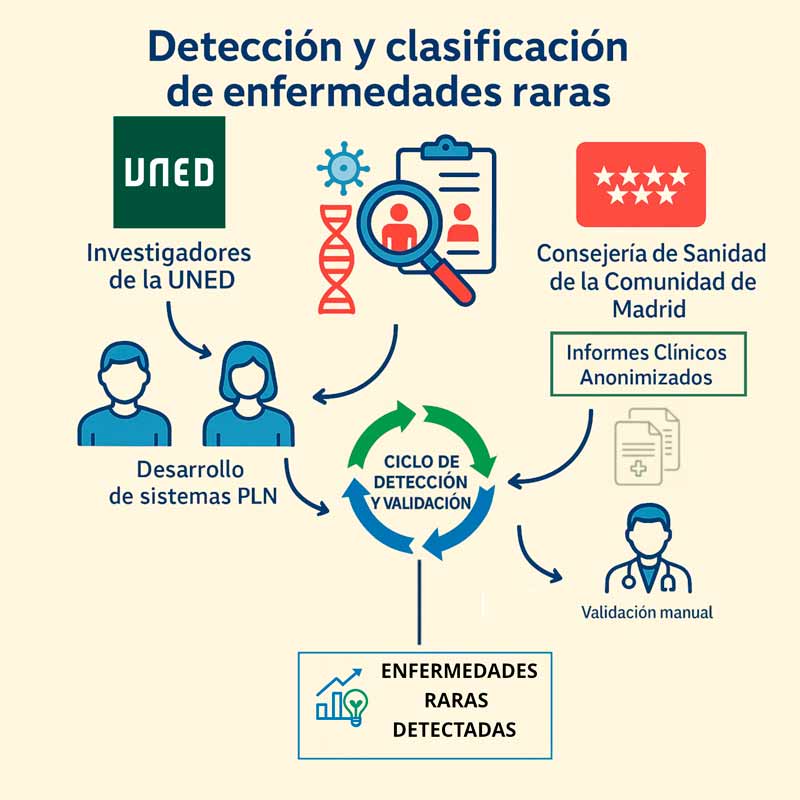
El trabajo de la UNED, en colaboración con profesionales del Registro de Enfermedades Raras de Madrid, está liderado por Juan Martínez-Romo, Lourdes Araujo y Andrés Duque. Ha permitido analizar casi 250.000 notas clínicas escritas por pediatras en la atención primaria. Toda esta información ha servido de base para crear un sistema automatizado para reconocer con precisión menciones a patologías poco frecuentes en registros médicos reales, redactados sin estandarización y con la complejidad inherente al lenguaje clínico.
Sistema para detectar enfermedades raras
Para enfrentarse a la maraña de historias clínicas, los investigadores diseñaron un sistema híbrido que combina métodos semisupervisados basados en palabras clave con los modelos de lenguaje más modernos. Todo comenzó con un diccionario compuesto por más de 9.000 enfermedades raras y sus variantes extraídas del repositorio internacional Orphanet.
Si en el mundo médico es normal encontrar formas alternativas del mismo término, en las enfermedades raras esa variabilidad se multiplica. Una misma patología puede aparecer como nombre propio, como acrónimo, como descripción clínica o incluso heredada del inglés. Por eso el equipo generó un vocabulario de casi 21.000 expresiones equivalentes capaces de capturar esta riqueza terminológica.
Con ese diccionario en la mano, el primer paso consistió en escanear todas las notas en busca de expresiones relevantes. Un algoritmo de extracción de frases clave redujo el ruido y destacó únicamente los fragmentos con sustantivos y adjetivos clínicos que pudieran referirse a alguna enfermedad. A partir de ahí, un sistema de coincidencia por bolsas de palabras permitía detectar equivalencias aunque el orden de los términos estuviera invertido o hubiera pequeñas variaciones lingüísticas.
Para evitar confusiones, el proceso incluía reglas específicas para descartar menciones ambiguas, acrónimos sospechosos y, sobre todo, casos en los que el pediatra hablaba de un familiar o descartaba la enfermedad después de pruebas. Un módulo de detección de negaciones y otro de historia familiar ajustaron todavía más la precisión.
Confirmar si los síntomas se ajustan a una enfermedad rara
Una vez identificado este primer conjunto de notas, comenzó la parte más delicada. Cuatro profesionales sanitarios revisaron uno a uno los posibles casos. No se trataba de quedarse con cualquier referencia aislada, sino de confirmar si el niño cumplía los criterios clínicos oficiales utilizados por el registro estatal de enfermedades raras.
Esta validación permitió construir un conjunto de datos depurado con mil novecientas historias clínicas agrupadas por paciente y clasificadas en una de las diecinueve enfermedades o en una categoría adicional para los casos descartados. El resultado mostró un fenómeno habitual en este campo. Algunas enfermedades contaban con cientos de ejemplos mientras que otras apenas aparecían un puñado de veces. Esta escasez de datos es una de las grandes barreras para el uso de inteligencia artificial en el diagnóstico médico.
Un proceso efectivo para identificar enfermedades raras
Los resultados muestran que el enfoque funciona muy bien. Los modelos más avanzados lograron identificar correctamente más del 78 % de los casos, una medida que combina precisión y capacidad de detección. Esto supone una mejora de más de diez puntos respecto a los primeros sistemas utilizados, un avance especialmente importante en un contexto donde los datos disponibles son limitados, como suele ocurrir con las enfermedades raras.
La precisión del sistema también se debe a la adaptación minuciosa al español clínico: manejo de negaciones, distinción entre enfermedades presentes y antecedentes familiares, o identificación de referencias indirectas. Todos ellos elementos clave para no confundir diagnósticos con sospechas, descartes o información heredada.
Registros médicos más robustos
El proyecto se alinea con iniciativas como el Registro Regional de Enfermedades Raras (SIERMA), promovido por la Dirección General de Salud Pública de la Comunidad de Madrid, que busca mejorar la identificación y seguimiento de casos desde la atención primaria.
Según los autores, este tipo de herramientas abre la puerta a incorporar la inteligencia artificial en procesos clínicos rutinarios, mejorar la detección precoz en pacientes pediátricos y reforzar los sistemas de vigilancia epidemiológica. La tecnología permitiría, a medio plazo, apoyar a los profesionales sanitarios en la lectura de miles de notas clínicas que hoy requieren un análisis manual.