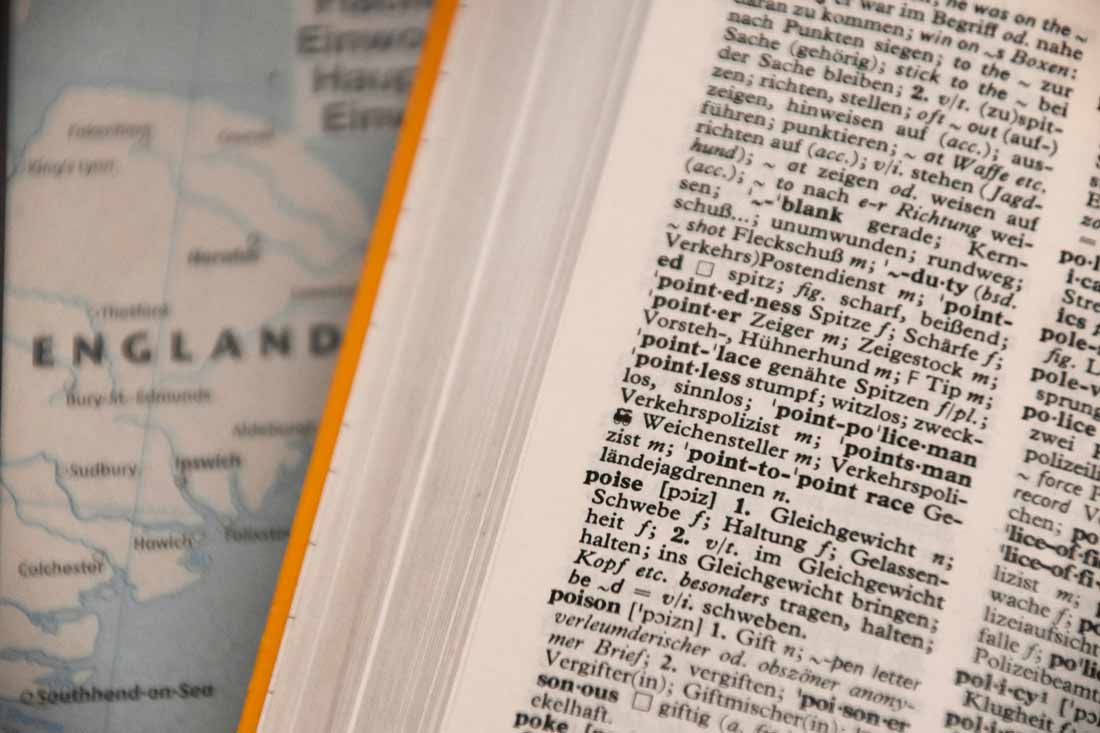
Una palabra mal escrita en un diccionario puede parecer un simple descuido. Una letra cambiada, una palabra que aparece donde no debería o un error que pasa inadvertido durante una revisión. Pero ¿qué ocurre cuando esas equivocaciones se repiten? Las erratas pueden revelar problemas mucho más profundos que un simple fallo de escritura. Pueden estar relacionadas con la forma en que se elaboran, revisan y actualizan los recursos lingüísticos, y algunos de estos errores incluso consiguen esquivar a las herramientas automáticas de corrección y traducción.
Esta es una de las principales conclusiones de una línea de investigación desarrollada durante los últimos ocho años por Santiago Rodríguez-Rubio Mediavilla, profesor del Área de Filología Inglesa de la Universidad Pablo de Olavide (UPO). Su trabajo ha reunido doce contribuciones académicas, varias de ellas realizadas junto a Nuria Fernández-Quesada, también profesora de la UPO.
La investigación analiza cómo se producen y por qué pasan inadvertidas las erratas en diccionarios, recursos digitales y herramientas de traducción automática.
El error que no es solo un error
Estamos acostumbrados a pensar en una errata como un accidente aislado: alguien pulsa una tecla equivocada, un corrector no detecta el fallo y la palabra termina publicada. Pero la investigación de Rodríguez-Rubio parte de una idea diferente. Cuando las anomalías se repiten, pueden indicar que detrás existe un patrón relacionado con el propio proceso de producción y revisión.
“Mi investigación rebate que las erratas y otros defectos formales sean menudencias, porque no se basa en fallos aislados, sino en sistemas de fallos vinculados al diseño y al proceso de producción de los diccionarios”, explica el investigador.
Su trabajo ha estudiado estas anomalías en diccionarios especializados bilingües en papel, entre ellos la serie lexicográfica de Alicante que sirvió de base para su tesis doctoral, pero también en recursos lingüísticos digitales y herramientas de traducción automática.
El resultado es una mirada al error mucho más amplia: no se trata únicamente de descubrir qué palabra está mal escrita, sino de entender por qué nadie la detectó antes.
Nuestro cerebro también puede ayudarnos a no ver las erratas
Uno de los fenómenos analizados en esta investigación es el llamado “efecto bañera”, relacionado con la tendencia a recordar mejor el principio y el final de una palabra que la parte central.
Esta peculiaridad puede hacer que determinadas erratas pasen inadvertidas. Si una palabra mantiene un comienzo y un final que nos resultan familiares, nuestro cerebro puede reconocerla sin prestar tanta atención a lo que ocurre en medio.
El problema no está necesariamente en que el lector no sepa cómo se escribe la palabra. Puede ocurrir que el cerebro complete o interprete automáticamente aquello que espera encontrar.
A esto se suman los propios sistemas de corrección de los procesadores de texto, que en determinadas circunstancias pueden introducir sustituciones inesperadas en lugar de solucionar el problema. Es decir, una herramienta diseñada para evitar errores puede, en determinados casos, convertirse también en parte de la cadena que los produce.
Google Translate y DeepL tampoco detectan todos los errores
La investigación se adentra además en un terreno especialmente relevante en la actualidad: qué hacen los traductores automáticos cuando reciben una palabra mal escrita.
Los trabajos analizan la respuesta de Google Translate y DeepL ante diferentes erratas. Y el resultado resulta llamativo: en determinados casos, estas herramientas reproducen directamente la palabra incorrecta en lugar de identificarla o corregirla.
El comportamiento mejora cuando la palabra aparece dentro de una frase y no de forma aislada. El contexto proporciona al sistema más información y puede ayudarle a interpretar qué término pretendía escribir el usuario.
Esto muestra una limitación importante de estas herramientas. Aunque sean capaces de traducir millones de palabras y analizar enormes cantidades de texto, no significa que puedan detectar cualquier error ortográfico antes de traducirlo.
La inteligencia artificial y los sistemas automáticos pueden ser extraordinariamente eficaces, pero también tienen sus propios puntos ciegos.
Los diccionarios digitales tampoco están libres de fallos sistemáticos
Otro de los trabajos de Rodríguez-Rubio se ha centrado en el diccionario en línea Cambridge, donde el investigador ha identificado patrones de anomalías formales.
La presencia de estos patrones apunta de nuevo a que determinados errores no tienen por qué ser fenómenos aislados. Pueden estar relacionados con la manera en que se generan, incorporan, revisan o actualizan los contenidos de un recurso lingüístico.
El estudio analiza incluso las perturbaciones que puede provocar la presencia de anuncios publicitarios durante la consulta del diccionario digital. La cuestión adquiere una dimensión especial porque los diccionarios en línea ya no son productos cerrados que se publican y permanecen inalterados durante años. Son recursos vivos, que incorporan nuevas palabras y modifican continuamente las existentes. Por eso, revisar una vez un diccionario no basta.
La tecnología ha mejorado, pero todavía necesitamos personas
La investigación adquiere especial relevancia en un momento en el que cada vez más procesos de corrección, edición y traducción dependen de herramientas automáticas.
La automatización permite reducir considerablemente los costes de producción y revisar cantidades de texto que serían difíciles de manejar exclusivamente con personas. Pero esa eficiencia tiene un límite: los sistemas automáticos no detectan necesariamente todos los errores y, en determinadas situaciones, pueden incluso contribuir a introducirlos.
“A pesar de que la tecnología de revisión ha mejorado enormemente, sigue dejando ángulos muertos; por tanto, la revisión humana sigue siendo fundamental”, afirma Rodríguez-Rubio.
La conclusión no implica que haya que prescindir de la tecnología. Más bien apunta hacia un modelo en el que las herramientas automáticas y la revisión humana se complementen.
Las máquinas pueden localizar determinados patrones a una velocidad enorme, mientras que las personas pueden interpretar el contexto, detectar anomalías inesperadas y cuestionar aquello que un sistema da por correcto.
Un diccionario nunca está realmente terminado
La última advertencia del investigador tiene que ver precisamente con la naturaleza cambiante de los recursos lingüísticos digitales. “Al ser un diccionario un ente orgánico, el mantenimiento tanto de las nuevas entradas como de las existentes es crucial”.
La frase resume uno de los principales mensajes de esta investigación. Un diccionario no es simplemente una colección de palabras que alguien revisa una vez y da por terminada. Es un sistema que necesita vigilancia y actualización constante. Y las erratas, lejos de ser siempre pequeñas imperfecciones sin importancia, pueden servir como pistas para detectar dónde falla ese sistema.