¿Cómo ‘piensa’ una inteligencia artificial en español? Detrás de cada respuesta, cada traducción y cada conversación fluida, hay un universo de datos meticulosamente seleccionados y procesados. Especialistas desarrollan un trabajo fascinante que impulsa proyectos como ALIA, la iniciativa española que está redefiniendo la IA en nuestro idioma.
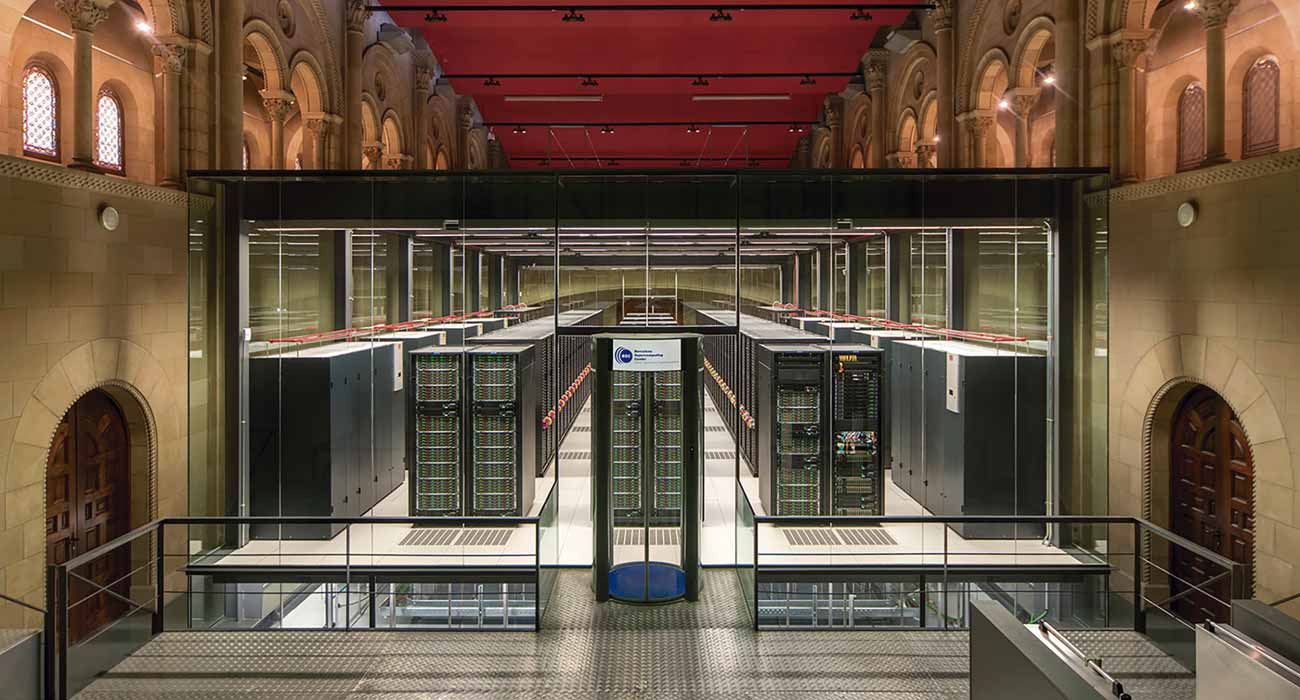
Imagina a un niño aprendiendo: acumula experiencias, procesa ‘datos’. La IA hace algo similar. Pero, a diferencia de un cerebro humano, no puede aprender sola. Necesita que le ‘alimentemos’ con datos estructurados, reglas y algoritmos. Así es como empieza a ‘pensar’. La inteligencia artificial en español y en las lenguas cooficiales que se está desarrollando en el marco del Proyecto ALIA no es distinta.
ALIA: el proyecto español que revoluciona la IA en nuestros idiomas
Recientemente, este proyecto español, enmarcado en la Estrategia Nacional de Inteligencia Artificial, ha marcado un hito con la publicación del modelo de lenguaje 40B Instruido, un avance crucial para el futuro de la IA en español. Este recurso tecnológico ha sido entrenado con 40.000 millones de parámetros y es el resultado de una de las mayores recopilaciones de datos en español y lenguas cooficiales realizadas hasta la fecha.
Cómo se alimenta la inteligencia artificial española
El Centro de Inteligencia Digital de la Provincia de Alicante (CENID) ha participado de forma activa en la recopilación de parte de los datos empleados en la configuración de la familias de modelos ALIA. Uno de los responsables de esta tarea ha sido el investigador del Grupo de Procesamiento del Lenguaje Natural y Sistemas de Información de la Universidad de Alicante, Juan Pablo Consuegra. Su trabajo ha consistido en la identificación de conjuntos de datos de calidad y de uso libre, así como en la creación de otros a partir de documentación de muy diversa índole. Además, los ha etiquetado y les ha dado el formato adecuado para su uso en el entrenamiento de sistemas de inteligencia artificial.
Los datos reunidos han sido muy variados, aunque en ningún caso se recogieron de forma aleatoria. Se han estructurado en torno a tres pilares fundamentales, con objetivos bien definidos. Por un lado, se ha recopilado información para conformar un bloque documental enfocado a la enseñanza de idiomas, en este caso el español y el valenciano. Por otro, se han reunido datos estructurados orientados a funciones y tareas específicas. Finalmente, se han incorporado datos de alineamiento con principios humanos, con el fin de que el modelo de lenguaje no solo funcione como una máquina que complete oraciones, sino como un asistente virtual capaz de entender lo que se le dice y de emplear un lenguaje no tóxico ni discriminatorio.
Para facilitar la recopilación de los millones de datos destinados a 40B y a otras aplicaciones de inteligencia artificial desarrolladas por el CENID en el proyecto ALIA, se ha recurrido a diversas fuentes.
«En general hemos utilizado conjuntos de datos ya procesados y de carácter abierto, y cuando no eran de libre acceso, hemos firmado acuerdos con las entidades propietarias para que nos los cedieran», explica Juan Pablo Consuegra.
Una vez obtenida la información, el equipo del CENID la ha procesado y le ha dado la forma necesaria para que pueda emplearse en tareas de entrenamiento de IA y en la construcción de modelos de inteligencia artificial. En el caso concreto de los idiomas, los llamados “datos crudos” se procesan, pero siguen siendo frases, oraciones o párrafos que ayudan al sistema a aprender una lengua y a comunicarse con los usuarios finales mediante lenguaje natural.
El reto del valenciano: así se entrena a la IA en una lengua cooficial
El trabajo con el idioma valenciano ha sido especialmente laborioso, ya que existen pocos datos estructurados para entrenar modelos de inteligencia artificial en esta lengua. Para ello, el CENID ha contado con especialistas que han revisado manualmente traducciones de parte de los conjuntos de datos, realizando los ajustes necesarios, dado que los traductores automáticos no alcanzan todavía la precisión deseada. Además, se han llevado a cabo tareas específicas para que el sistema aprenda a distinguir el valenciano del catalán, dos lenguas que en ocasiones pueden confundirse. Este esfuerzo ha permitido crear un modelo de traducción al valenciano, que también está disponible para su integración en otras aplicaciones de inteligencia artificial.
En el caso de los datos orientados a tareas de instrucción, se ha seguido un procedimiento similar. Algunos conjuntos de datos ya están bien estructurados y pueden utilizarse casi directamente, mientras que otros requieren un tratamiento especial, destinado a “construir manualmente datos de instrucción”, según explica Consuegra. Para ilustrar este proceso, el equipo del CENID ha recopilado información web sobre turismo y la ha preparado en formato de pregunta-respuesta, con el fin de resolver cuestiones como la playa más popular, las fiestas tradicionales de la provincia de Alicante u otras consultas similares.
De forma adicional, se ha realizado un filtrado exhaustivo para descartar textos demasiado breves o documentos que contengan símbolos susceptibles de inducir a error. Asimismo, especialmente en los datos obtenidos de la web sin procesamiento previo, se ha prestado especial atención a la eliminación de información de carácter personal que pudiera vulnerar la privacidad. Del mismo modo, el equipo del CENID ha tomado medidas para que los datos no introduzcan sesgos de género ni referencias de carácter discriminatorio.
La importancia de la evaluación y el futuro de la IA en español
Los datos de entrenamiento son fundamentales, pero no lo son menos los datos de evaluación. En este sentido, los investigadores han desarrollado una herramienta específica para medir la calidad de las respuestas generadas por el sistema. Los datos son, en definitiva, el combustible de la inteligencia artificial, su experiencia, retomando la comparación con el niño. Por ello, su preparación debe ser meticulosa y rigurosa: un trabajo de meses llevado a cabo por el CENID y el resto de centros implicados en ALIA, que están sentando las bases de la inteligencia artificial en los idiomas españoles.
La meticulosa preparación y gestión de los datos son el pilar fundamental sobre el que se construye la inteligencia artificial, especialmente en el complejo ámbito del procesamiento del lenguaje natural en español y lenguas cooficiales. El esfuerzo del CENID y el Proyecto ALIA no solo demuestra la viabilidad de crear modelos de lenguaje avanzados en nuestro idioma, sino que también establece un estándar de rigor y ética en la recopilación y el tratamiento de la información. Este trabajo pionero es esencial para el futuro de la IA en el mundo hispanohablante, asegurando sistemas más precisos, justos y culturalmente relevantes.