Cualquier modelo de inteligencia artificial aprende de la información que recibe: noticias, estudios científicos, páginas web y millones de textos más. Pero entre esos datos también hay bulos, insultos, errores y contenidos manipulados. ¿Qué ocurre cuando una máquina aprende de todo ello? Investigadores de las universidades de Alicante y Jaén trabajan para conseguir que los modelos de lenguaje aprendan de información de calidad y sean capaces de reconocer aquello que no deberían reproducir.
Cómo aprende una inteligencia artificial de los datos que recibe
En la Universidad de Alicante, el Grupo de Procesamiento del Lenguaje y Sistemas de Información (GPLSI), adscrito al Centro de Inteligencia Digital de Alicante (CENID), trata los materiales para construir y entrenar estos sistemas. Su objetivo es que una máquina no solo tenga mucha información, sino que aprenda a distinguir la que es fiable de la que no lo es, a detectar aquello que puede resultar dañino y a evitar reproducirlo.
Este es el propósito del proyecto HEART-NPL, en el que también participa el Grupo de Sistemas Inteligentes y Acceso a la Información de la Universidad de Jaén, liderado por Luis Alfonso Ureña. La propuesta consiste en crear un ecosistema de recursos, con bases de datos, documentos, grafos de conocimiento y modelos de lenguaje, que sirva para desarrollar herramientas de inteligencia artificial en distintos ámbitos.
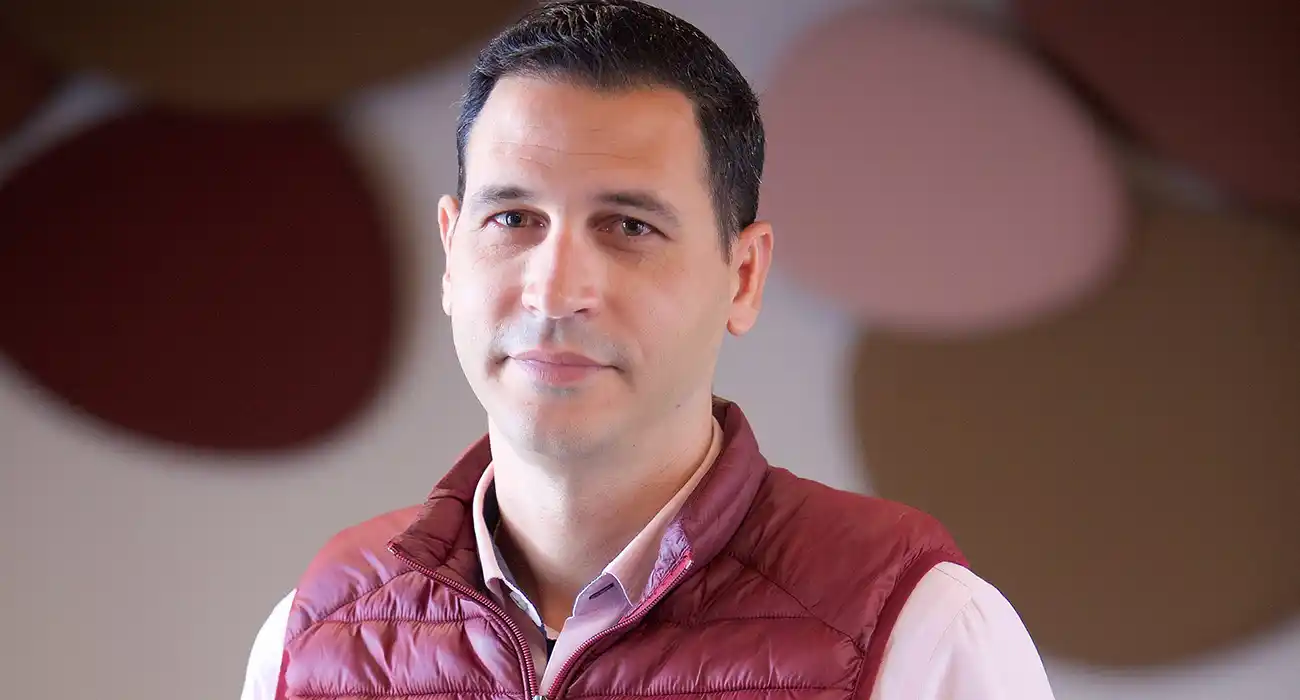
«Los recursos son lo más importante para crear un sistema de inteligencia artificial; sin información es imposible crear nada y si esa información es de mala calidad, el modelo aprende mal», explica el investigador de GPLSI, Yoan Gutiérrez.
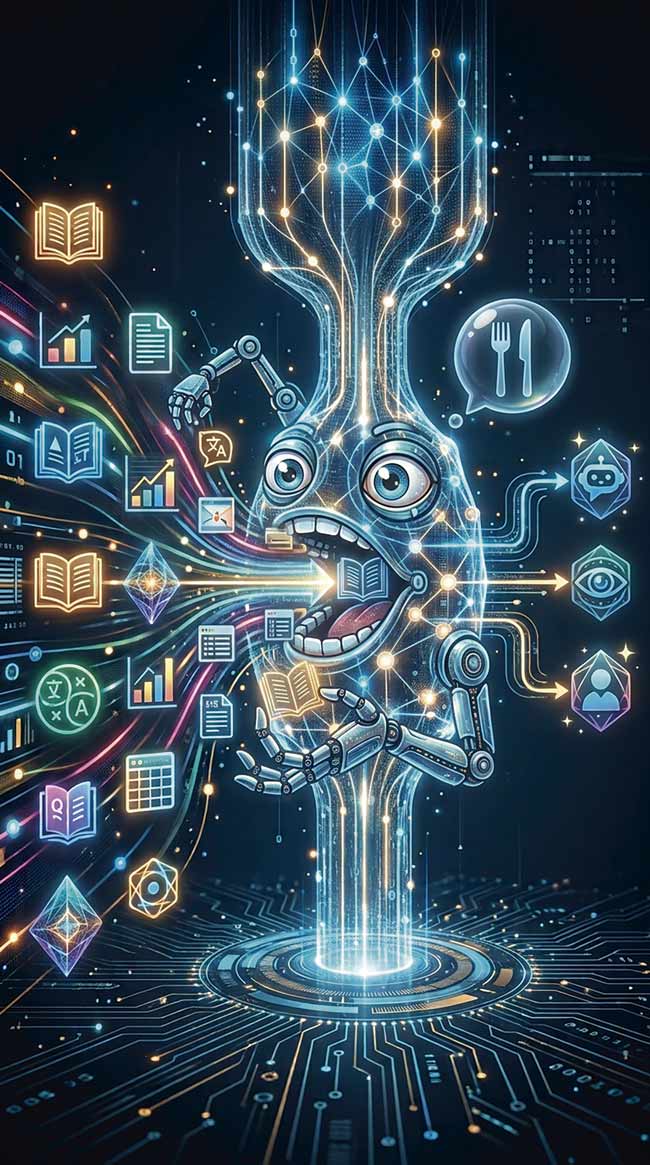
La imagen habitual de una inteligencia artificial es la de una máquina que responde. Escribimos una pregunta y, unos segundos después, aparece un texto aparentemente coherente. Pero entre una cosa y otra hay un proceso mucho más complejo. El modelo ha tenido que aprender a partir de enormes cantidades de información.
Datos de calidad para evitar errores y sesgos en la IA
Ahí aparece uno de los problemas que aborda HEART-NPL, porque no toda la información sirve para enseñar a una máquina. Si los datos contienen errores, prejuicios, información falsa o contenidos malintencionados, el modelo puede incorporarlos a su aprendizaje.
«Si para la construcción de sistemas de inteligencia artificial usas datos no validados, los modelos aprenderán lo bueno, pero también lo no tan bueno», advierte Gutiérrez. Eso puede traducirse en sesgos, errores o confusiones y contribuir a las conocidas como alucinaciones de los sistemas de inteligencia artificial.
Por eso, el proyecto comienza mucho antes de que exista el modelo. Los investigadores recopilan y organizan información y la someten a procesos de validación y curación. Son datos estructurados y no estructurados, documentos, conocimiento organizado en grafos y otros recursos que pueden servir después para entrenar modelos o para desarrollar aplicaciones.

El trabajo se divide además por áreas. Hay información general y conjuntos especializados en turismo, salud y ámbito jurídico. La especialización es importante porque una inteligencia artificial no necesita saberlo todo para ser útil. En ocasiones necesita saber mucho sobre una cosa concreta.
El equipo trabaja con una idea que va un paso más allá de alimentar de información a una máquina. También pretende enseñarle a reconocer aquello que no debería reproducir.
«Cuando creamos estos recursos cuidamos que sean lo más limpio y saludables a nivel de sociedad posible», explica Gutiérrez.
Para conseguirlo, los investigadores proporcionan a los modelos miles de ejemplos. Noticias falsas, insultos, contenidos de acoso o información incorrecta pueden convertirse así en ejemplos que permitan al sistema aprender a reconocer esos patrones.
Enseñar a la IA a reconocer información perjudicial
La inteligencia artificial puede utilizarse entonces para analizar contenidos. Por ejemplo, puede examinar mensajes publicados en redes sociales y detectar indicios de acoso, lenguaje ofensivo, información falsa o determinados sesgos. Pero también puede utilizarse para generar contenido que se ajuste a criterios de calidad, veracidad y seguridad.
La intención, resume el investigador, es «intentar no hacer daño y enseñarle a detectar el daño».
Ese principio se extiende incluso a las respuestas que el modelo debe negarse a proporcionar. Una inteligencia artificial construida dentro de este ecosistema debe ser capaz de proteger datos privados o confidenciales y evitar determinadas respuestas cuando la información solicitada pueda utilizarse con fines peligrosos.
«Cuando creamos los modelos, además de tratar de que aprendan de estos datos sanos, les enseñamos a protegerse y a no generar información que pueda ser dañina”, señala Gutiérrez.
La investigación también muestra hacia dónde puede avanzar esta tecnología. Un modelo de lenguaje genérico puede realizar muchas tareas diferentes. Pero si se especializa, puede concentrar sus capacidades en un ámbito concreto.
Modelos de inteligencia artificial especializados en salud
Es lo que ocurre, por ejemplo, en el trabajo con salud. Los investigadores están utilizando historiales clínicos para desarrollar algoritmos capaces de analizarlos y extraer elementos relevantes que puedan ayudar en determinadas tareas relacionadas con el diagnóstico.
En este caso, el modelo no necesita comportarse como una herramienta capaz de hablar de cualquier asunto. Necesita comprender especialmente bien el lenguaje y la información médica. Al especializarlo, pierde parte de su capacidad para realizar tareas generales, pero gana capacidad para desenvolverse en ese campo concreto.
La lógica es parecida a la de un profesional que se especializa. Cuanto más específico es su conocimiento, más centrado está en un determinado tipo de problemas.
La calidad de los datos, clave para una IA más fiable
Gutiérrez compara estos modelos con «un cerebro artificial» capaz de procesar las peticiones de los usuarios y construir respuestas a partir de la información que posee. Pero en HEART-NPL hay una condición previa. Ese cerebro debe haber aprendido con materiales cuidadosamente seleccionados.
La filosofía del proyecto se asemeja a la de la dieta saludable. Si una inteligencia artificial se alimenta con los datos adecuados, no solo funcionará mejor, sino que también velará por la salud del ecosistema. Porque al final no se trata de fabricar modelos cada vez más grandes, sino de cuidar que estén bien alimentados con una información de calidad.